KI-News · Werkzeuge
Token sparen in Claude Code:
Was wirklich hilft.
EN Read in English
Token-Kosten entstehen beim Programmieren mit einem Agenten an verschiedenen Stellen: beim erzeugten Code, beim Finden der richtigen Datei und in langen Werkzeugausgaben. Ich habe Ponytail, Graphify und RTK am selben Projekt getestet. Die drei helfen, aber nicht auf dieselbe Weise und nicht bei jeder Aufgabe.
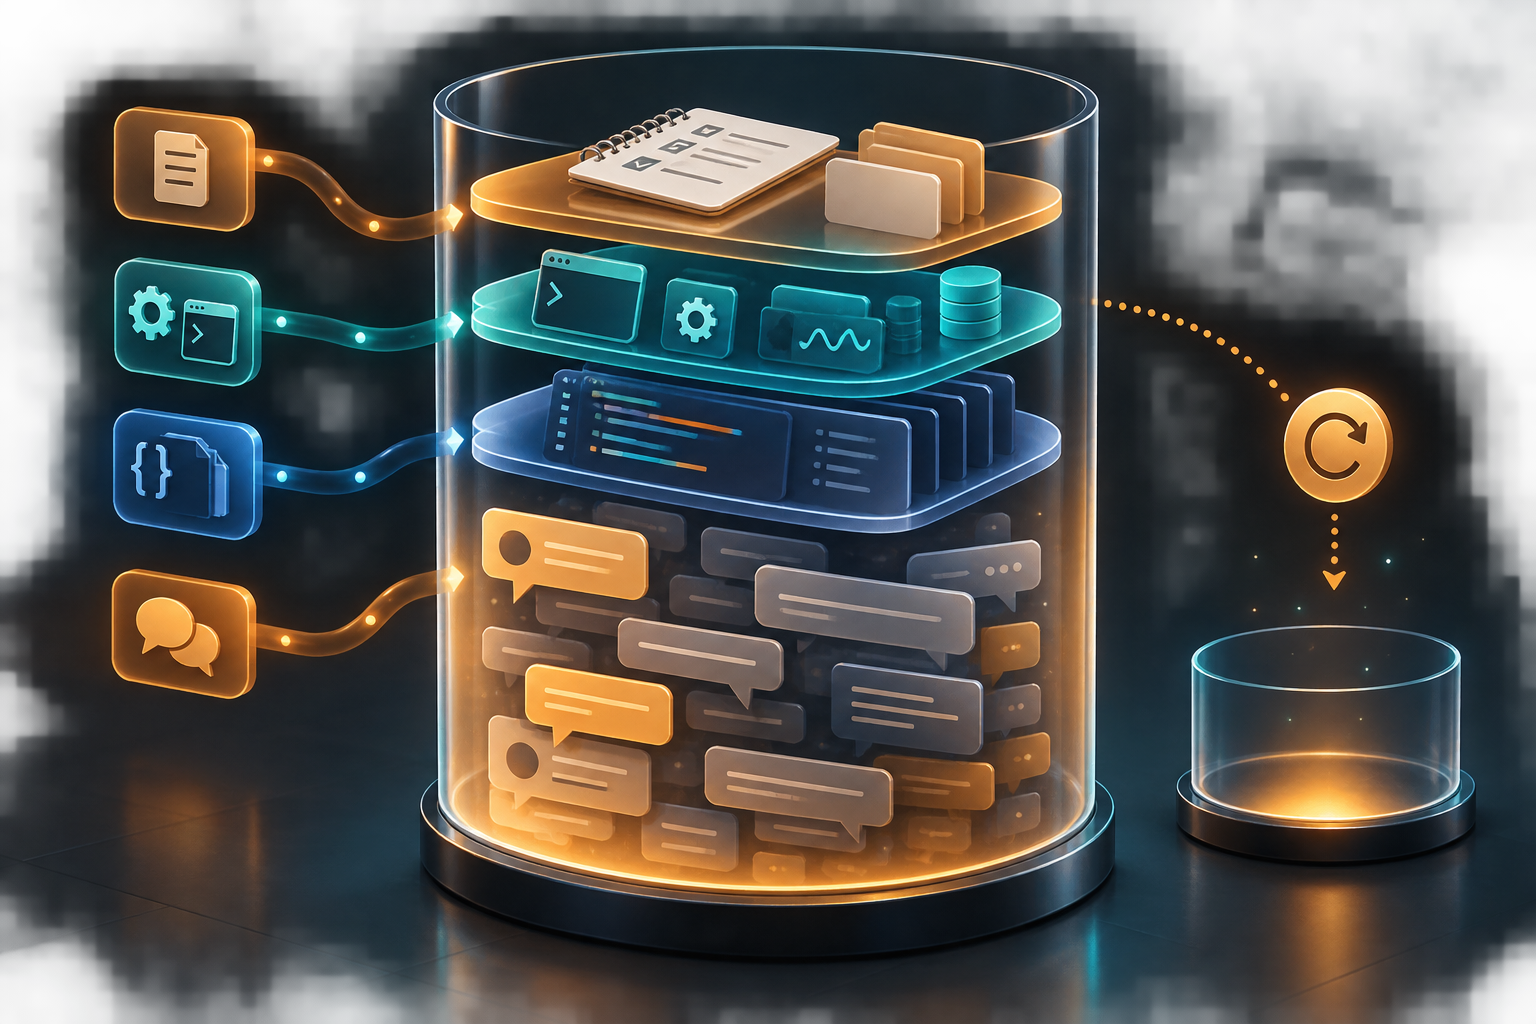
Ein Coding-Agent arbeitet mit dem, was im Kontextfenster steht: Projektanweisungen, gelesene Dateien, Werkzeugausgaben und Gesprächsverlauf. Je mehr davon für eine Anfrage verarbeitet wird, desto höher sind in der Regel die Input-Kosten. Prompt-Caching und automatische Verdichtung verändern die Rechnung, beseitigen sie aber nicht.
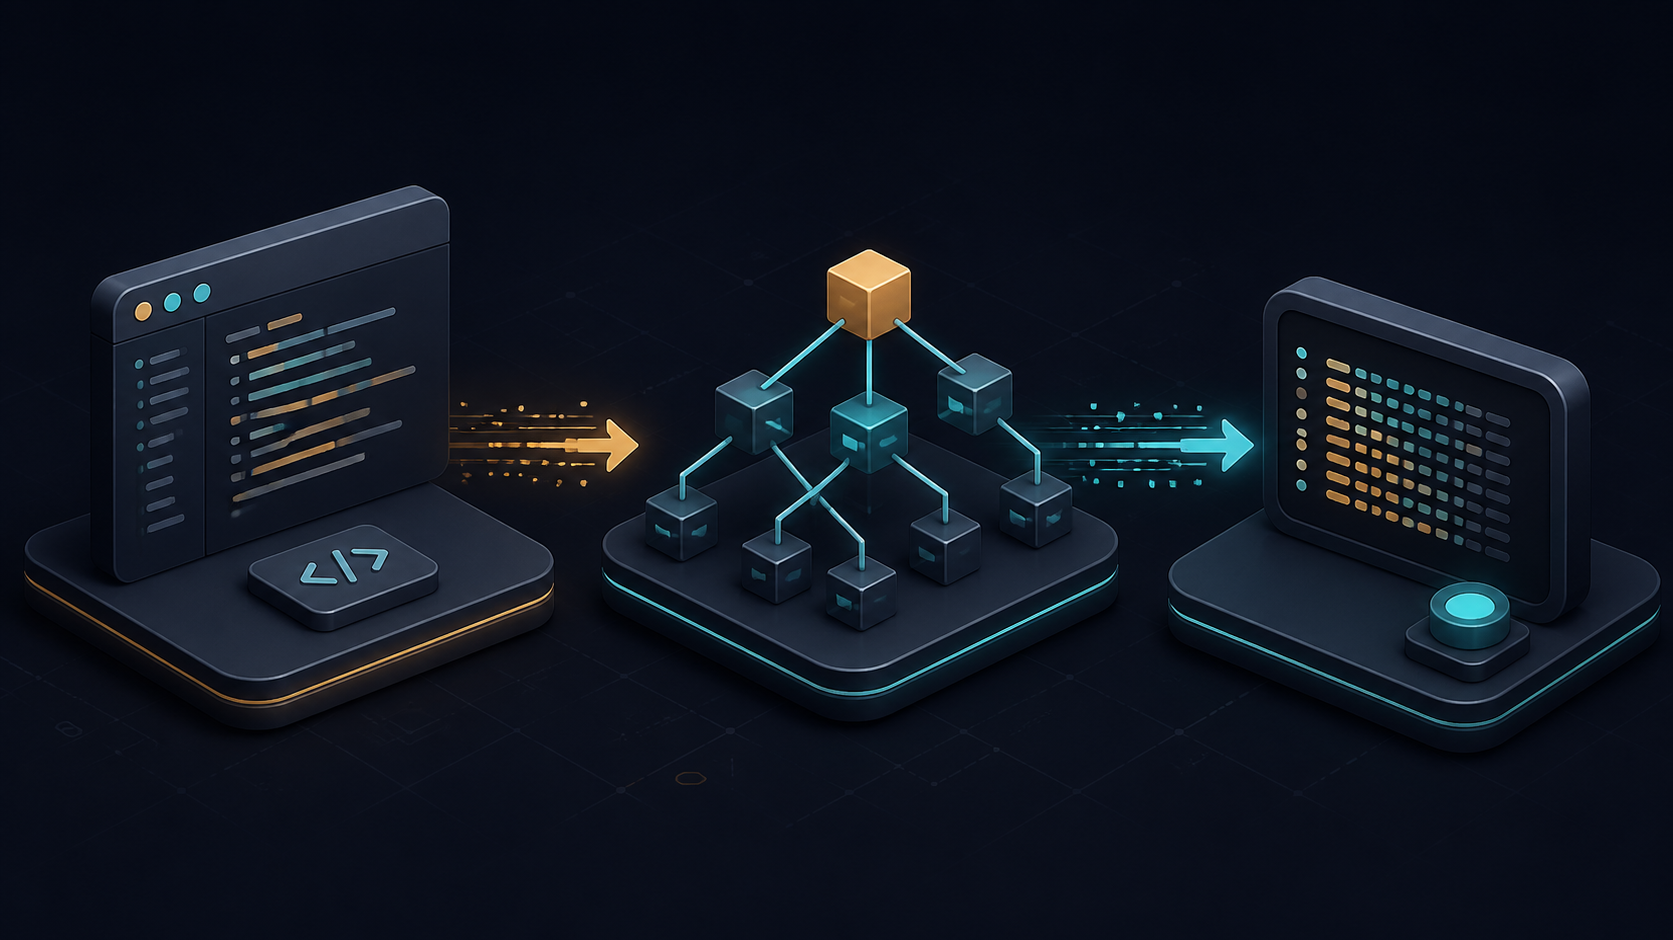
Die drei Werkzeuge in diesem Beitrag greifen deshalb an verschiedenen Punkten ein. Ponytail soll unnötigen Code verhindern. Graphify soll die Suche im Repository verkürzen. RTK reduziert die Ausgabe von Entwicklungswerkzeugen, bevor sie beim Agenten ankommt.
Drei Messwerte, drei unterschiedliche Aufgaben
Die Balken zeigen keine Rangliste. Sie messen jeweils einen anderen Teil des Arbeitsablaufs.
Die drei Ansätze im Vergleich
| Werkzeug | Setzt an bei | Spart | Aufwand | Gemessen |
|---|---|---|---|---|
| Ponytail | Wie viel Code der Agent schreibt | Output-Tokens | Skill installieren | −43 % (netto) |
| Graphify | Wie der Agent Code findet | Input-Tokens beim Suchen | Index bauen, pflegen | −96 % (gezielt) |
| RTK | Wie viel Werkzeugausgabe zurückkommt | Input-Tokens aus Tool-Calls | Einmalig Hook einrichten | −89 % (47 Cmds) |
Die Werkzeuge lassen sich kombinieren, weil sie unterschiedliche Teile des Arbeitsablaufs betreffen.
Ponytail: weniger Code schreiben lassen
Der „faule Senior-Entwickler“ als Skill
Ponytail auf GitHub · Skill für Claude Code, Codex, Cursor, Gemini CLI u. a.
Ponytail ist eine Skill-Datei mit einer kurzen Prüfreihenfolge. Vor dem Schreiben soll der Agent klären, ob die Funktion bereits existiert, sich mit einer Standardfunktion lösen lässt oder überhaupt gebraucht wird. Sobald eine einfache Lösung reicht, endet die Suche.
Dadurch entstehen weniger Output-Tokens und weniger Code, der später gepflegt werden muss. Überflüssiger Code kostet über seine Lebensdauer meist mehr als seine Erzeugung.
Und hier wird es interessant. Ein unabhängiger Test zeigt ein sehr uneinheitliches Bild:
- Große, offene Aufgabe („bau ein Admin-Dashboard“): 101 statt 464 Zeilen Code, 3,6K statt 8,4K Tokens. Deutlicher Gewinn.
- Kleine, scharf umrissene Aufgaben (User-Auth, CSV-Export, Rate Limiting): kein Vorteil bis Nachteil. Bei der Auth-Aufgabe waren es 6K statt 2,3K Tokens, also mehr als ohne, weil der Agent zusätzlich über die Ponytail-Leiter nachdenkt.
Ein anderer Test auf einem FastAPI-/React-Projekt kommt auf 54 % weniger Code bei 22 % weniger Tokens und 20 % niedrigeren Kosten. Das passt zu meinem Ergebnis: Ponytail hilft vor allem bei Aufgaben, bei denen ein Agent sonst zu viel baut. Bei einem präzisen Ticket ist die zusätzliche Prüfreihenfolge eher Aufwand.
Nachgemessen: die Leiter an einer echten Aufgabe
Die Aufgabe an PlantWiz lautete: „CSV-Export der Pflanzliste." Ein typisch knapp formuliertes Ticket. Ich habe es bewusst so gewählt, dass die Leiter nichts geschenkt bekommt: Es gab im Projekt keinerlei CSV-Code, keine passende Bibliothek, nichts zum Wiederverwenden. Ponytail konnte hier nur kürzen, nicht streichen. Ich habe die Aufgabe zweimal umgesetzt, einmal geradeheraus, einmal mit der Leiter.
| Ergebnis | Ohne Ponytail | Mit Ponytail | Differenz |
|---|---|---|---|
| Neue Dateien | 6 | 1 | −5 |
| Codezeilen | 569 | 104 | −81,7 % |
| Zeichen | 18.059 | 3.539 | −80,4 % |
| Output-Tokens (≈) | 4.515 | 885 | −80,4 % |
Die Variante ohne Leiter baute, was ein gründlicher Entwickler eben baut: eine Typdatei mit
Optionsobjekt, einen RFC-4180-Serialisierer, eine Spaltendefinition mit zehn wählbaren Feldern,
ein Composable mit localStorage-Persistenz, ein Modal mit Spaltenauswahl,
Trennzeichen- und Datumsoptionen samt Live-Vorschau sowie 103 Zeilen Tests. Nichts davon ist
falsch. Es ist nur nichts davon angefordert worden.
Die Variante mit Leiter landete auf Sprosse 4 (native Plattformfunktion?): ein
Blob und ein Anker-Element. Keine Bibliothek. Es blieben 44 Zeilen in einem Composable,
ein Knopf neben dem bestehenden PDF-Export, ein Test für das Einzige, was hier wirklich
knifflig ist: das Quoting von Semikola und Anführungszeichen. Die Formel-Entschärfung gegen
CSV-Injection blieb drin, denn Ponytail nimmt Sicherheitsmaßnahmen ausdrücklich von der Kürzung aus.
Der Preis: die Leiter kostet auch, wenn sie nichts findet
Dazu ein zweiter Punkt, der sich schlecht beziffern lässt: Die gekürzte Variante ist ärmer. Kein Trennzeichen-Wechsel, keine Spaltenauswahl. Wenn übermorgen jemand nach einem Komma-Export fragt, wird nachgebaut. Dieser Nachbau kostet erneut Tokens. Ponytail wettet darauf, dass die Frage meistens nicht kommt. Diese Wette ist in der Regel richtig, aber sie ist eine Wette, keine Ersparnis.
Bei offen formulierten Aufgaben sind rund 40 % netto realistisch; bei präzisen Tickets kann der Effekt null oder leicht negativ sein. Die 465 nicht geschriebenen Zeilen müssen später auch nicht gewartet, gelesen oder migriert werden.
GET/PUT /admin/user-plans und einen vollständigen Benutzer-Tab von 93 Zeilen in
AdminView.vue besaß. Die halbe Aufgabe war erledigt, nur wusste es niemand mehr.
Die Variante ohne Leiter hat sie kommentarlos ein zweites Mal gebaut. Als Messwert taugt der
Fall nichts. Er ist ein Ausreißer nach oben, als Argument für die Leiter jedoch nützlich.
Graphify: den Code als Graph durchsuchen
Wissensgraph statt Grep
Graphify auf GitHub · graphify.net
Graphify parst ein Projekt lokal mit tree-sitter (rund 40 Sprachen) und baut daraus einen abfragbaren Wissensgraphen: Dateien, Symbole, Abhängigkeiten und deren Beziehungen. Statt sich durch Dateien zu suchen, kann der Agent den Graphen abfragen: Was hängt an dieser Funktion? Welcher Pfad führt von A nach B?
Technisch sauber gelöst: Der Graph landet als graph.json im Projekt, keine
Vektordatenbank nötig. Jede Kante trägt Metadaten, ob sie direkt im Quelltext gefunden
(EXTRACTED) oder aus Abhängigkeiten erschlossen wurde (INFERRED).
Diese Ehrlichkeit über die eigene Sicherheit ist selten und gut.
Zwei Einschränkungen, die man kennen muss:
- Der Graph ist ein abgeleitetes Artefakt. Er veraltet, sobald sich der Code ändert. Ein Index, der hinter der Realität herhinkt, führt den Agenten mit Überzeugung in die Irre.
- Der Doku-Teil kostet API-Aufrufe. Die Code-Analyse läuft komplett lokal. Die semantische Extraktion aus PDFs und Dokumentation braucht einen API-Key und damit Geld. Bei einem großen Dokumentenbestand ist das ein laufender Posten.
Nachgemessen: Orientierung im Adminbereich
Der Indexbau an PlantWiz dauerte 38 Sekunden für 258 Codedateien und
ergab 2.014 Knoten, 2.994 Kanten und 179 Cluster. Die graph.json ist 1,7 MB groß.
die liest der Agent nie am Stück, er fragt sie ab.
Dieselbe Aufgabe, dieselbe Frage: Welche Dateien muss ich anfassen, und wie hängen sie zusammen? Einmal klassisch mit Suchen und Lesen, einmal über den Graphen:
| Weg | Aufrufe | Kontext |
|---|---|---|
| Klassisch: grep + Dateien lesen | grep -rln · admin.ts · AdminView.vue | 63.241 B |
| Graphify: gezielt abfragen | explain admin.ts · explain AdminView.vue | 2.552 B |
| Ersparnis | −96,0 % |
Der Grund für den Abstand ist banal: AdminView.vue hat 1.323 Zeilen und 51 KB.
Wer wissen will, was darin steckt, liest im Normalfall alles. graphify explain
liefert für 1.948 Bytes die Liste aller 58 enthaltenen Symbole mit Zeilennummern. Das reicht, um
zu entscheiden, welche 40 Zeilen man wirklich braucht.
Der Preis: zwei Lücken, die man kennen muss
graphify query "admin area user
    management"
lieferte 6.498 Bytes und darin plantPairs.ts, eine Datei über
Pflanzennachbarschaften, in der die Wörter admin, user und garden kein einziges Mal
vorkommen. Der Treffer entstand über unscharfen Namensabgleich. Wer den Symbolnamen schon kennt,
bekommt mit explain exzellente Antworten. Wer ihn sucht, bekommt Rauschen. Gerade
genau dann bräuchte man den Graphen am dringendsten.
graphify path "AdminView.vue"
    "gardens.ts"
antwortet: No path found. Dabei ruft die Komponente die Admin-API
nachweislich auf, nur per fetch() über HTTP. Keine statische Analyse
sieht diese Kante. In einem Full-Stack-Projekt bekommt man deshalb nicht einen Graphen, sondern
zwei unverbundene: Frontend und Backend. Für die häufige Frage „welches Backend
hängt an diesem Formular?" hilft der Graph nicht weiter.
Dazu zwei kleinere Baustellen aus dem Protokoll: 27 .sql-Dateien trugen nichts
bei, weil tree_sitter_sql nicht mitinstalliert wird. Bei PlantWiz mit einer 4 MB
großen init.sql ist das das halbe Datenmodell. Und 11 weitere Dateien ergaben
schlicht null Knoten.
Graphify lohnt sich, sobald ein Projekt über den Prototypen hinausgeht, aber mit realistischer
Erwartung. Es erklärt eine bekannte Datei hervorragend und hilft weniger beim Finden dieser
Datei. In meiner Messung war zuerst nach Dateinamen zu suchen und anschließend
explain aufzurufen der günstigste Weg. Den Index-Neubau sollten Sie im
Pre-Commit-Hook oder in der CI verankern, damit der Graph aktuell bleibt.
RTK: Werkzeugausgabe verdichten
Rust Token Killer
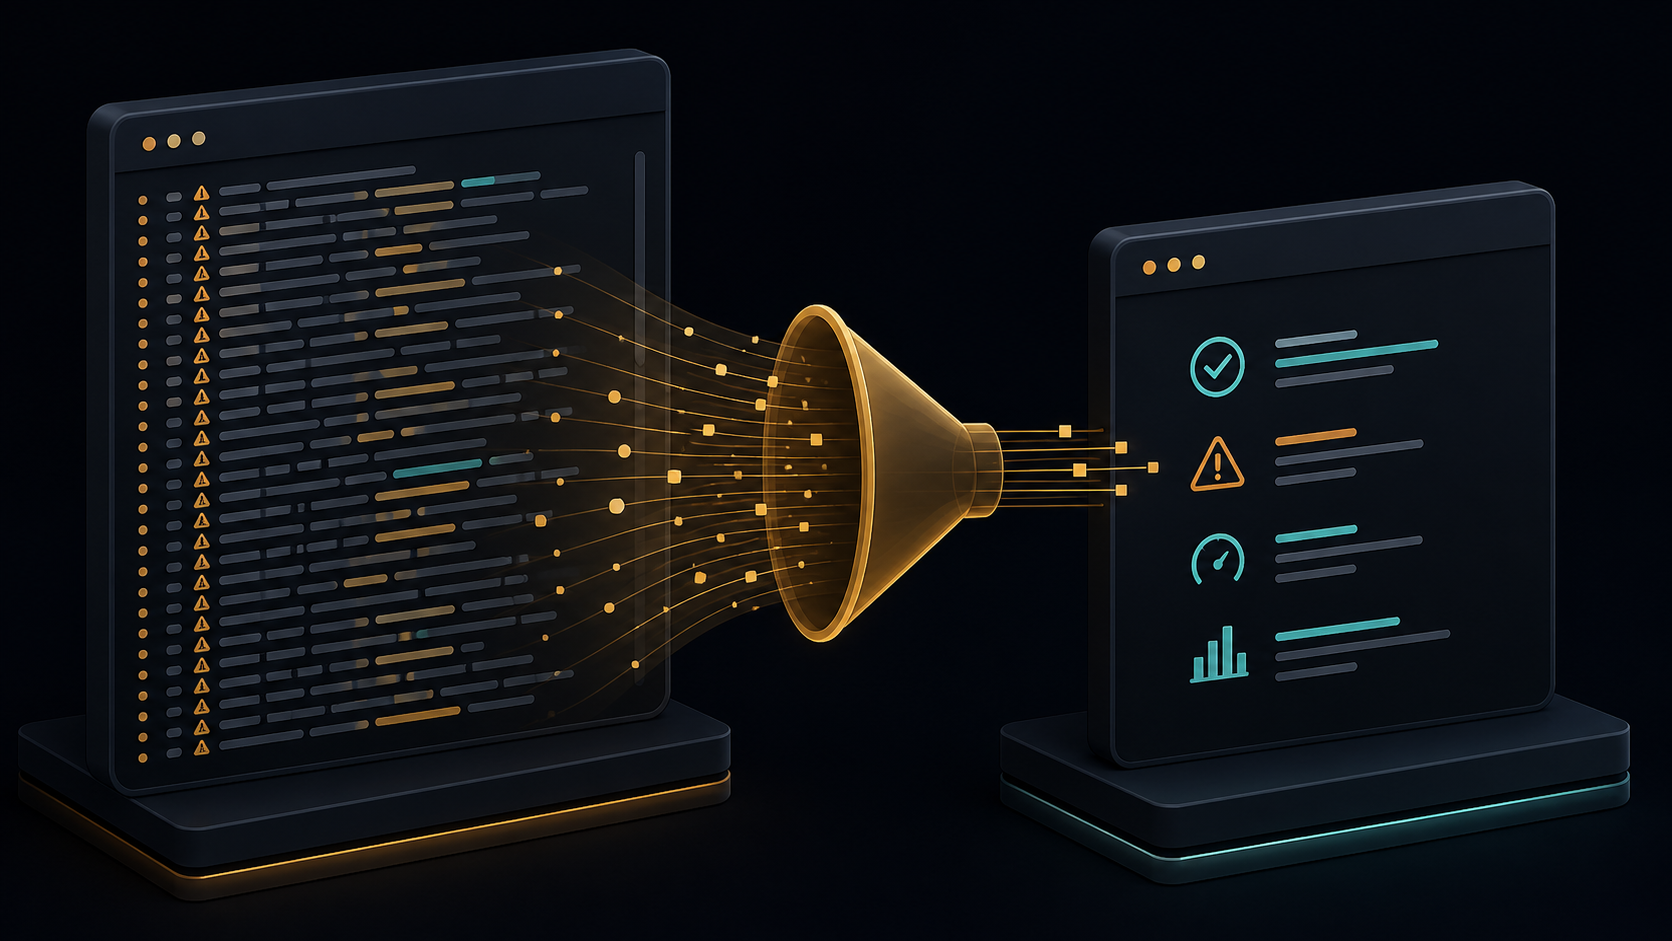
RTK ist der unspektakulärste und aus meiner Sicht überzeugendste der drei. Es ist ein CLI-Proxy, der die Ausgabe gängiger Entwickler-Kommandos verdichtet, bevor sie beim Agenten ankommt: Wiederholungen werden zusammengefasst, Dateien und Fehler gruppiert, lange Ausgaben gekürzt.
Über einen PreToolUse-Hook geschieht das transparent: git status wird
automatisch zu rtk git status umgeschrieben. Man merkt im Alltag nichts davon.
Über 100 Kommandos werden abgedeckt: Git, Testrunner, Buildtools, Paketmanager, Docker,
Kubernetes. Angegeben sind 60–90 % Ersparnis, bei cargo test bis −90 %.
rtk
(Rust Type Kit). Wenn nach der Installation rtk gain nicht funktioniert, haben Sie
das falsche Binary. Prüfen mit rtk --version.
Warum RTK am schnellsten wirkt: Es ist die einzige der drei Maßnahmen, die keine Verhaltensänderung verlangt und kein Artefakt pflegen lässt. Einmal einrichten, danach wirkt es im Hintergrund. Und es greift genau dort, wo in der Praxis am meisten Kontext verbrannt wird: bei Testausgaben und Buildlogs.
Nachgemessen: 47 Kommandos im Alltag
Herstellerangaben sind Herstellerangaben. Ich habe RTK 0.43 deshalb an einem produktiven Projekt gegengeprüft: PlantWiz, eine Vue-3-Anwendung mit Node-Backend, rund 45.000 Zeilen TypeScript und Vue, 327 Unit-Tests. Jeweils dasselbe Kommando einmal roh und einmal durch RTK, gemessen in Bytes der Ausgabe:
| Kommando | Roh | Mit RTK | Ersparnis |
|---|---|---|---|
| vitest run (327 Tests) | 7.719 B | 20 B | −99,7 % |
| git diff HEAD~3 HEAD | 467.163 B | 44.026 B | −90,6 % |
| ls frontend/src | 888 B | 166 B | −81,3 % |
| git status | 705 B | 282 B | −60,0 % |
| find *.vue | 1.265 B | 556 B | −56,0 % |
| deps (package.json) | 1.073 B | 482 B | −55,1 % |
| git log --oneline -30 | 1.272 B | 1.272 B | ±0 % |
| grep -rn "fetch(" | 1.175 B | 1.175 B | ±0 % |
Über alle im Projekt abgesetzten Kommandos hinweg meldet rtk gain nach 47 Aufrufen
149.000 geschätzte eingesparte Tokens bei 167.300 Roh-Tokens, also 89,1 %.
RTK leitet die Token-Zahl aus Ausgabebytes ab. Für dieses Projekt liegt der Wert damit am oberen Ende der vom Hersteller genannten Spanne von 60 bis 90 Prozent.
Drei Beobachtungen dazu. Erstens: Der Gewinn ist extrem ungleich verteilt. Ein einziger
git diff machte 106.000 der 149.000 gesparten Tokens aus. Zweitens: Bei Kommandos,
die von Haus aus kompakt sind, etwa git log --oneline oder ein Grep mit wenigen Treffern,
passiert schlicht nichts, RTK reicht sie unverändert durch. Kein Schaden, aber auch kein Nutzen.
Drittens: Der Effekt ist am größten bei genau den Ausgaben, die man ohnehin am seltensten
komplett liest. Testrunner und Buildlogs sind zu 95 % Formatierung.
Der Preis: Information geht verloren
Drei Stellen, an denen mir das in der Messung konkret aufgefallen ist:
- Der Testlauf schrumpft auf eine Zeile. Aus 79 Zeilen Vitest-Ausgabe wird
PASS (327) FAIL (0). Weg sind dabei nicht nur Farbcodes: In der Rohausgabe stand einstderr-Block aus einem Test, der einen Netzwerkfehler protokolliert. Harmlos in diesem Fall. Ein Agent, der nur die eine Zeile sieht, kann echte Warnungen, Deprecation-Hinweise oder auffällig langsame Tests nicht mehr bemerken. - Der Diff verliert seine Struktur. Die komprimierte Fassung wirft
Hunk-Header und teilweise die
+/−-Marker weg; übrig bleiben Codezeilen ohne erkennbare Zuordnung, und am Ende steht[530 more lines]. Für einen Überblick reicht das. Für die Frage „wurde diese Zeile hinzugefügt oder entfernt?“ nicht mehr. - Metadaten fallen ersatzlos weg.
rtk lsliefert Namen und Größen, aber keine Änderungsdaten und keine Rechte. Wer wissen will, welche Datei zuletzt angefasst wurde, muss erneut nachfragen und zahlt den zweiten Aufruf.
Der Umgang damit ist einfach, man muss ihn nur kennen: RTK ist richtig für den Normalfall und
falsch für die Fehlersuche. Wenn ein Test rot ist und der Agent im Kreis läuft, gehört die
Rohausgabe her. rtk proxy <kommando> umgeht den Filter. Wer das nicht tut,
riskiert das schlechteste aller Ergebnisse: einen Agenten, der auf Basis einer Zusammenfassung
rät und dabei mehr Tokens verbrennt, als der Filter je gespart hat.
Was Sie vor der Installation prüfen sollten
Diese Gewohnheiten kosten kein zusätzliches Werkzeug und senken oft mehr Kontext als ein neuer Hook.
1. Den Kontext bewusst leeren
Eine lange Session enthält auch frühere Versuche, gelesene Dateien und Werkzeugausgaben. Das
kann die Kosten pro weiterer Anfrage erhöhen und die Orientierung erschweren. Für unabhängige
Aufgaben lohnt sich ein frischer Kontext mit /clear; bei einer fortlaufenden Aufgabe
kann /compact die bessere Wahl sein.
2. MCP-Server gezielt laden
Prüfen Sie mit /context, welche MCP-Tools tatsächlich Kontext belegen. Claude Code
lädt bei aktiviertem Tool Search
standardmäßig nur Tool-Namen und holt vollständige Definitionen erst bei Bedarf. Server mit
alwaysLoad, deaktiviertem Tool Search oder umfangreichen Beschreibungen können
dennoch spürbar Platz beanspruchen. Nicht benötigte Server abzuschalten bleibt sinnvoll, ist
aber kein pauschaler Token-Spartrick.
3. Suchen delegieren
Wenn eine Frage viele Dateien betrifft, kann ein Subagent die Recherche übernehmen. Er arbeitet in einem eigenen Kontextfenster und gibt nur das Ergebnis zurück. Das spart im Hauptverlauf Kontext, kostet aber einen zusätzlichen Agentenaufruf. Für eine einfache Suche ist das oft zu viel, für eine umfangreiche Bestandsaufnahme kann es sich lohnen.
4. Das passende Modell wählen
Nicht jede Aufgabe braucht das stärkste Modell. Umbenennungen, Formatierungen, einfache Textänderungen erledigt ein kleineres Modell zu einem Bruchteil der Kosten. Die Kunst ist, den Wechsel zur Gewohnheit zu machen.
5. Erst planen, dann bauen
Der Plan-Modus wirkt wie ein Umweg, ist aber oft der kürzere Weg. Ein Agent, der in die falsche Richtung losläuft und zurückgebaut werden muss, kostet ein Vielfaches der Tokens, die eine Abstimmung vorher gekostet hätte.
6. Die Projektanweisungen kurz halten
Globale Anweisungen werden am Beginn einer Session geladen. Halten Sie sie deshalb so kurz,
dass sie bei jeder Aufgabe nützen. Ausführliche Abläufe gehören in Dateien, die der Agent nur
bei Bedarf liest. Prüfen Sie mit /context, was in Ihrer Konfiguration wirklich
geladen wurde. Die offizielle Kontextansicht
zeigt, welche Inhalte in welcher Phase dazukommen.
Eine sinnvolle Reihenfolge
Die Werkzeuge ergänzen sich. Ich würde sie in dieser Reihenfolge prüfen:
- Den eigenen Kontext prüfen. Nutzen Sie
/context, beenden Sie unabhängige Aufgaben mit/clearund räumen Sie globale Anweisungen auf. - RTK einrichten. Die Einrichtung ist klein und der Nutzen zeigt sich bei
umfangreichen Test- und Buildausgaben. Für die Fehlersuche sollte
rtk proxybekannt sein. - Ponytail bei offenen Aufgaben testen. In meiner Messung blieben nach den Skill-Kosten 43 Prozent Nettoersparnis. Bei exakt beschriebenen Tickets kann die Rechnung auch negativ ausfallen.
- Graphify nur mit Pflegeplan einführen. Bei bekannten Dateien war die Abfrage sehr sparsam. Der Index muss aktuell bleiben und bildet HTTP-Verbindungen nicht zuverlässig ab.
Die größten Einsparungen kamen in meinen Messungen von einzelnen Fällen. Bei RTK war es ein
git diff mit 106.000 der 149.000 geschätzt eingesparten Tokens. Bei Graphify war
es eine 51-KB-Datei, die sonst vollständig gelesen worden wäre. Bei Ponytail fiel ein
Optionsmodal weg, das im Ticket nicht verlangt war. Rechnen Sie deshalb mit punktuellen statt
gleichmäßigen Einsparungen.
Rechnen Sie bei jedem Werkzeug netto. Ponytail bringt in diesem Fall brutto 80 Prozent weniger Output, nach den rund 1.700 Tokens für den Skill bleiben 43 Prozent. Auch eine Graphify-Abfrage kostet Kontext, wenn sie am Ziel vorbeigeht. RTK reduziert Werkzeugausgabe; seine Tokenangaben sind dabei eine Schätzung aus Bytes, keine Abrechnung des Modellanbieters.
Messen Sie vor und nach einer Änderung an den Aufgaben, die Ihr Team wirklich bearbeitet. Notieren Sie Modell, Tool-Version, Aufgabenstellung und die verwendete Metrik. Dann lässt sich entscheiden, ob ein Werkzeug Kosten senkt oder nur anders verteilt.
Token-Kosten im Griff?
Ich richte Claude Code in Entwicklerteams ein, inklusive Hooks, Skills und der Frage, welche Aufgaben überhaupt an einen Agenten gehören. 30 Minuten Erstgespräch, kostenlos.