Grundlagen · Arbeitsweise
Prompt, Kontext, Harness oder Loop?
Die richtige Stellschraube finden.
EN Read in English
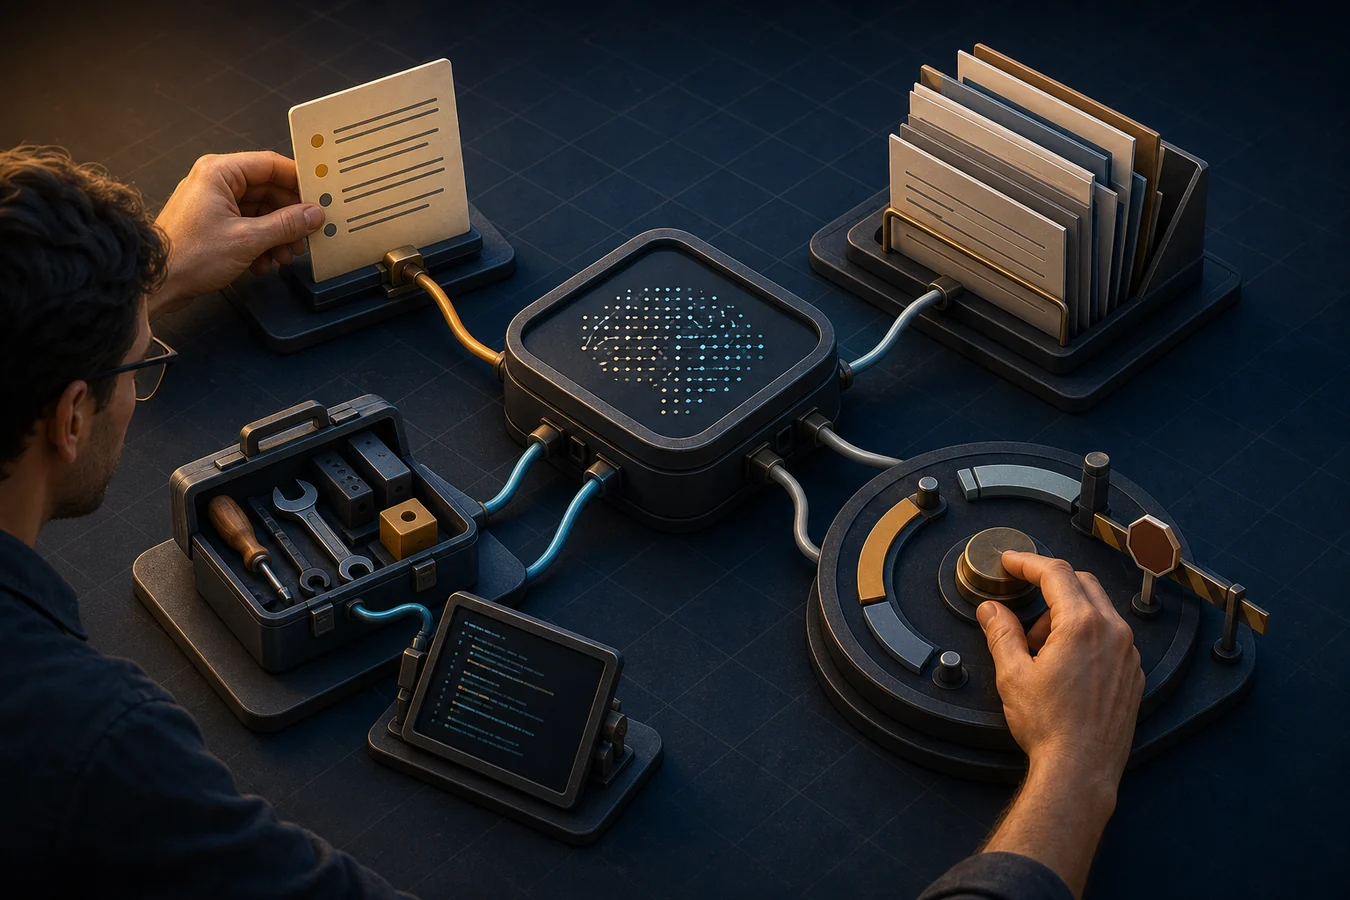
Wenn ein KI-Agent schlechte Arbeit abliefert, landet die erste Änderung oft im Prompt. Das hilft nur, wenn dort auch die Ursache liegt. Vielleicht fehlte eine Datei im Kontext, das Werkzeug war missverständlich oder der Agent durfte aufhören, bevor ein Test lief. Prompt, Kontext, Harness und Loop benennen diese vier unterschiedlichen Fehlerquellen.
Vier Fragen statt vier Modewörter
Ein Chat mit einem Sprachmodell lässt sich noch fast vollständig über die Anweisung und den mitgegebenen Text erklären. Ein Agent hat zusätzlich Werkzeuge, verändert Dateien, sammelt neue Informationen und läuft über mehrere Modellaufrufe. Dadurch entstehen vier Fragen:
| Bereich | Arbeitsfrage | Typische Änderung |
|---|---|---|
| Prompt | Ist die Aufgabe eindeutig beschrieben? | Ziel, Grenzen, Beispiele, Ausgabeformat |
| Kontext | Sieht das Modell gerade die richtigen Informationen? | Retrieval, Verlauf, Zusammenfassung, Werkzeugausgaben |
| Harness | Kann der Agent sicher handeln und sein Ergebnis prüfen? | Werkzeuge, Rechte, Sandbox, Tests, Protokolle |
| Loop | Was löst den nächsten Schritt aus und wann ist Schluss? | Wiederholung, Abbruch, Status, Eskalation |
Das ist keine Schichtenarchitektur mit festen Grenzen. Ein Systemprompt gehört zugleich zum Prompt und zum Kontext. Ein Test ist Teil des Harnesses, sein Ergebnis kann aber den Loop steuern. Die Begriffe sind dann nützlich, wenn sie zu einer überprüfbaren Änderung führen.
1. Prompt: Ist der Auftrag eindeutig?
Anweisung
Was soll das Modell in diesem Schritt tun?
Stellschrauben: Ziel, relevante Grenzen, Beispiele, Ausgabeformat, Erfolgskriterium
Prompt Engineering gestaltet die Anweisungen, die das Modell liest. Dazu gehören der Nutzerauftrag, dauerhaft geladene Systemanweisungen und auch Werkzeugbeschreibungen. Ein guter Prompt sagt konkret, welches Ergebnis gebraucht wird und woran es erkennbar ist.
Ein Beispiel: „Prüfe den Vertrag“ lässt offen, ob eine Zusammenfassung, eine Risikoliste oder konkrete Änderungsvorschläge erwartet werden. „Nenne jede Kündigungsfrist mit Abschnitt, Fristlänge und frühestem Kündigungsdatum“ lässt sich prüfen. Zwei oder drei typische Beispiele helfen, wenn das gewünschte Format mit Regeln allein schwer zu beschreiben ist.
Prompt-Probleme zeigen sich häufig sofort und wiederholbar: Das Modell liefert die falsche Struktur, missachtet eine klar benennbare Einschränkung oder versteht einen Fachbegriff anders als das Team. Dann ist eine Änderung an der Anweisung plausibel. Fehlt dem Modell dagegen der aktuelle Vertrag, wird auch der schönste Prompt keine Kündigungsfrist finden.
2. Kontext: Liegen die richtigen Informationen vor?
Auswahl
Was steht beim nächsten Modellaufruf im Kontextfenster?
Stellschrauben: Retrieval, Verlauf, Kompaktierung, Notizen, Werkzeugausgaben
Zum Kontext zählen Systemanweisungen, Nachrichtenverlauf, geladene Dokumente, Werkzeugdefinitionen und Ergebnisse früherer Schritte. Context Engineering entscheidet, was davon für den nächsten Aufruf erhalten, nachgeladen, verdichtet oder entfernt wird.
Anthropic beschreibt das Ziel als eine möglichst kleine, hochwertige Auswahl an Token, die das gewünschte Verhalten ermöglicht. „Klein“ heißt dabei nicht automatisch „kurz“. Eine fehlende Spezifikation spart Token und verschlechtert trotzdem das Ergebnis. Umgekehrt können lange Logs die entscheidende Fehlermeldung verdecken und Kosten verursachen.
Der oft genannte „Context Rot“ ist keine feste Schwelle, ab der ein Modell plötzlich versagt. Die Leistung kann bei langen Kontexten je nach Modell, Aufgabe und Position der Information sinken. Deshalb sollte man mit realen Aufgaben messen, ob relevante Details noch gefunden und korrekt benutzt werden. Die Fenstergröße allein beantwortet diese Frage nicht.
- Gezielt nachladen: erst suchen, dann nur die passenden Dateien oder Abschnitte öffnen.
- Werkzeugausgaben begrenzen: relevante Zeilen und Fehlermeldungen behalten, wiederholte Logs kürzen.
- Zustand außerhalb des Chats sichern: Fortschritt, Entscheidungen und offene Punkte in versionierten Dateien ablegen.
- Verdichtung prüfen: nach einer Zusammenfassung kontrollieren, ob offene Fehler, Pfade und Entscheidungen noch vorhanden sind.
In einem RAG-System gehören Chunking, Suche, Ranking und die Anzahl mitgegebener Treffer genau hierher. Bei Coding-Agenten sind Dateisuche, Projektanweisungen und der Umgang mit langen Terminalausgaben dieselbe Art von Arbeit.
3. Harness: Kann der Agent sicher arbeiten?
Arbeitsumgebung
Welche Aktionen sind möglich, sichtbar und überprüfbar?
Stellschrauben: Werkzeuge, Rechte, Sandbox, Dateisystem, Tests, Logs
Das Harness ist die technische Umgebung um das Modell. Es reicht Werkzeuge und Kontext an, führt Aktionen aus, begrenzt Zugriffe und macht Ergebnisse beobachtbar. Je nach Autor gehört der eigentliche Agenten-Loop ebenfalls zum Harness. Für die Diagnose trenne ich hier Umgebung und Wiederholungslogik.
Ein gutes Beispiel liefert Anthropics Versuch mit einem lang laufenden Coding-Agenten. Ein Initialisierungslauf erstellte für einen Claude.ai-Nachbau eine Liste mit mehr als 200 prüfbaren Merkmalen. Spätere Sitzungen lasen Git-Verlauf und Fortschrittsdatei, arbeiteten jeweils an einem kleinen Teil und prüften die Anwendung per Browserautomation. Anthropic beschreibt diesen Aufbau als eine mögliche Lösung für lange Aufgaben, nicht als allgemeinen Benchmark.
Auch der Werkzeugschnitt gehört hierher. Überlappende Namen, unklare Parameter und riesige Antworten erhöhen die Fehlerquote. Anthropic empfiehlt deshalb klare funktionale Grenzen und Evaluationen mit echten Aufgaben. Dass ein Werkzeug technisch funktioniert, sagt noch nichts darüber aus, ob ein Agent zuverlässig erkennt, wann und wie er es benutzen soll.
Rechte und Sandbox sind keine Nebensache. Ein Agent kann auf eine Prompt Injection hereinfallen oder einen destruktiven Befehl falsch verstehen. Dateisystem- und Netzwerkgrenzen begrenzen den Schaden, während Freigaben für sensible Aktionen beim Menschen bleiben.
4. Loop: Was passiert nach dem ersten Ergebnis?
Ablauf
Wie werden Beobachtung, Korrektur und Ende gesteuert?
Stellschrauben: Trigger, Status, Wiederholung, Abbruch, Eskalation, Freigabe
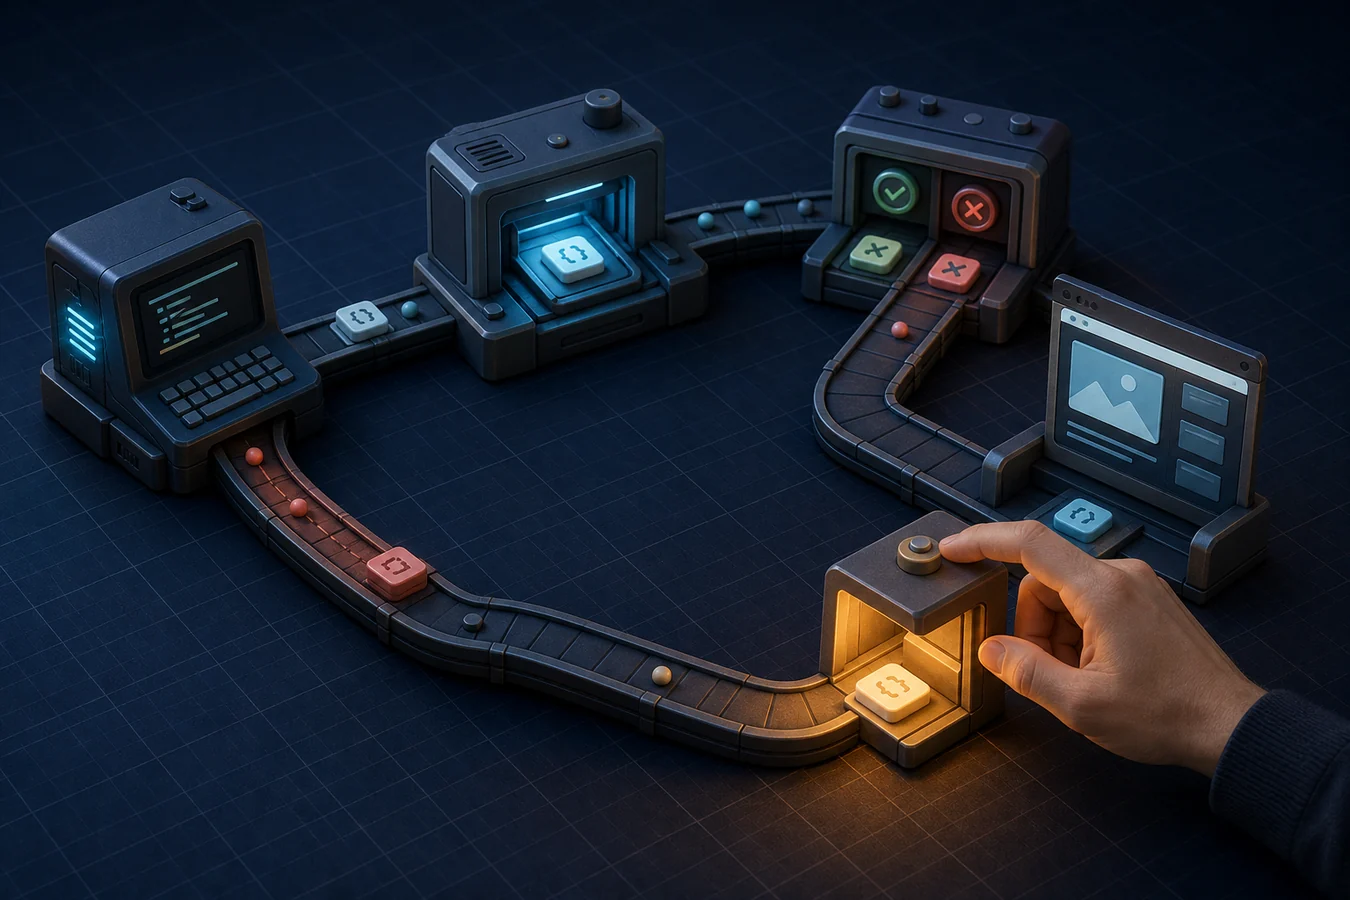
Loop Engineering gestaltet den wiederholten Ablauf: Aufgabe wählen, handeln, Ergebnis beobachten, gegebenenfalls korrigieren und mit einem klar benannten Zustand enden. IBM nennt den Begriff im Juli 2026 ausdrücklich eine junge Praxis. Andere Autoren zählen Teile davon zum Harness. Diese Unschärfe sollte in einem Projekt einmal geklärt werden.
Ein Test macht einen Fehler sichtbar. Er garantiert noch keine Verbesserung. Der Agent kann die Fehlermeldung falsch deuten, denselben Versuch wiederholen oder sogar den Prüfer verändern, wenn die Rechte das zulassen. Anthropics Langzeitversuch verbot deshalb ausdrücklich, die Merkmalsprüfungen zu löschen oder umzuschreiben. Der Loop braucht außerdem eine Grenze für Wiederholungen und einen Weg zum Menschen, wenn sich ein Fehler festfährt.
Was Wiederholung rechnerisch leisten kann
Dieses Modell zeigt die Chance auf mindestens einen erfolgreichen Versuch. Verändern Sie Einzelerfolg und Höchstzahl der Versuche.
Annahme: Jeder Versuch ist unabhängig und gleich gut. Agentenläufe erfüllen diese Annahme selten. Sie übernehmen fehlerhaften Zustand, reagieren unterschiedlich auf Feedback und kosten Zeit sowie Token. Der Rechner zeigt den theoretischen Nutzen von Wiederholung, nicht die erwartbare Produktionsleistung.
In meinem Weltmodell-Projekt trat eine verwandte Schwäche auf. Der Planer bewertete Handlungsfolgen mit einem gelernten Modell. Dieses Modell sagte Belohnungen voraus, die in der echten Umgebung nicht eintraten. Mehr Planungsschritte verstärkten den Messfehler, weil Handlung und Prüfsignal zu eng aus derselben Quelle kamen.
Welcher Bereich begrenzt gerade?
Ein Fehler kann mehrere Ursachen haben. Der Finder zeigt deshalb den sinnvollsten ersten Prüfpunkt, keine endgültige Diagnose.
Fehlerbild auswählen
Welches Verhalten beobachten Sie?
Stehen Struktur, Pflichtfelder und ein prüfbares Beispiel in der Anweisung? Testen Sie dieselbe Aufgabe mit einer eindeutigeren Ausgabespezifikation.
Die Grenzen fransen aus
Anthropic definiert in einem Beitrag von April 2026 das Harness als den Loop, der das Modell aufruft und Werkzeugaufrufe an die Infrastruktur weiterleitet. OpenAI verwendet Harness Engineering breiter für Repository-Struktur, Agentenlesbarkeit, Werkzeuge, Feedbackschleifen und mechanisch erzwungene Regeln. Die enge Trennung dieses Beitrags ist also eine Arbeitsweise, kein Industriestandard.
Das ist im Alltag kein Problem, solange ein Team konkret bleibt. „Wir brauchen besseres Harness Engineering“ ist noch keine Aufgabe. „Der Agent darf den Produktionsspeicher lesen, aber nicht schreiben, und jeder Schreibversuch braucht eine Freigabe“ ist eine umsetzbare Anforderung.
Was allen vier Bereichen fehlt: eine Messlatte
Ohne feste Testaufgaben bleibt jede Verbesserung eine Einzelbeobachtung. Für einen ersten Vergleich genügt oft ein kleiner Satz realer Fälle: typische Aufgaben, zwei oder drei Grenzfälle und bekannte Erfolgskriterien. Weil Modellausgaben schwanken, sollte jeder Fall mehrfach laufen. Anthropic unterscheidet bei Agenten-Evaluationen deshalb zwischen Aufgabe, einzelnen Versuchen, Prüfern und dem vollständigen Ablaufprotokoll.
Messen Sie mindestens Ergebnisqualität, Laufzeit, Tokenverbrauch, Werkzeugfehler und nötige Eingriffe durch Menschen. Ändern Sie danach nur einen Bereich. Sonst wissen Sie zwar, dass der neue Aufbau anders arbeitet, aber nicht, welche Änderung geholfen hat.
Eine brauchbare Reihenfolge für die Fehlersuche
- Fehler festhalten. Aufgabe, Modellversion, Kontext, Werkzeugaufrufe und Ergebnis sichern.
- Erfolg prüfbar machen. Vor der Änderung festlegen, woran ein korrektes Ergebnis erkennbar ist.
- Am beobachteten Fehler beginnen. Falsches Format deutet zuerst auf den Prompt, fehlende Fakten auf den Kontext, falsche Aktionen auf das Harness und vorzeitiges Ende auf den Loop.
- Nur eine Stellschraube ändern. Danach dieselben Aufgaben in mehreren Versuchen erneut ausführen.
- Nebenwirkungen prüfen. Eine höhere Erfolgsquote kann mit mehr Laufzeit, höheren Kosten oder größeren Rechten erkauft sein.
In meinen Projekten beginnt die Arbeit deshalb selten mit einer langen Prompt-Sitzung. Ich schaue zuerst in das Ablaufprotokoll: Was wusste das Modell, welches Werkzeug wählte es, welches Signal bekam es zurück und warum durfte es aufhören? Danach ist meist klar, an welcher Stelle sich ein gezielter Test lohnt.
Quellen und weiterführende Beiträge
- Anthropic: Effective context engineering for AI agents, 29. September 2025
- Anthropic: Effective harnesses for long-running agents, 26. November 2025
- Anthropic: Writing effective tools for AI agents, 11. September 2025
- Anthropic: Demystifying evals for AI agents, 9. Januar 2026
- Anthropic: Scaling Managed Agents, 8. April 2026
- OpenAI: Harness engineering, 11. Februar 2026
- IBM: What is loop engineering?, 17. Juli 2026
Das eigene Agentensystem durchgehen
In meinen Schulungen zerlegen wir reale Abläufe in Prompt, Kontext, Harness und Loop. So wird aus „der Agent ist unzuverlässig“ eine Liste prüfbarer Änderungen. Das Erstgespräch dauert 30 Minuten und ist kostenlos.